Actualités des organisations
|
OMJC
|
Soirée théma novembre 2026 |
|||||||
|---|---|---|---|---|---|---|---|---|
|
Hauts-de-France 🇫🇷 Publié le jeudi 05 novembre 2026 11h38 Importé le jeudi 05 novembre 2026 13h04 |
le méliès soirée du 14/11/2026
|
|||||||
|
LinuxFr
|
Fedora Linux 45 est enfin disponible ! |
|||||||
|
Internet Publié le jeudi 05 novembre 2026 10h00 Importé le jeudi 05 novembre 2026 13h03 |
En ce mardi 3 novembre, les utilisateurs du Projet Fedora seront ravis d'apprendre la disponibilité de la version Fedora Linux 45. Fedora Linux est une distribution communautaire développée par le projet Fedora et sponsorisée par Red Hat, qui lui fournit des développeurs ainsi que des moyens financiers et logistiques. Fedora Linux peut être vue comme une sorte de vitrine technologique pour le monde du logiciel libre, c’est pourquoi elle est prompte à inclure des nouveautés.
Sommaire
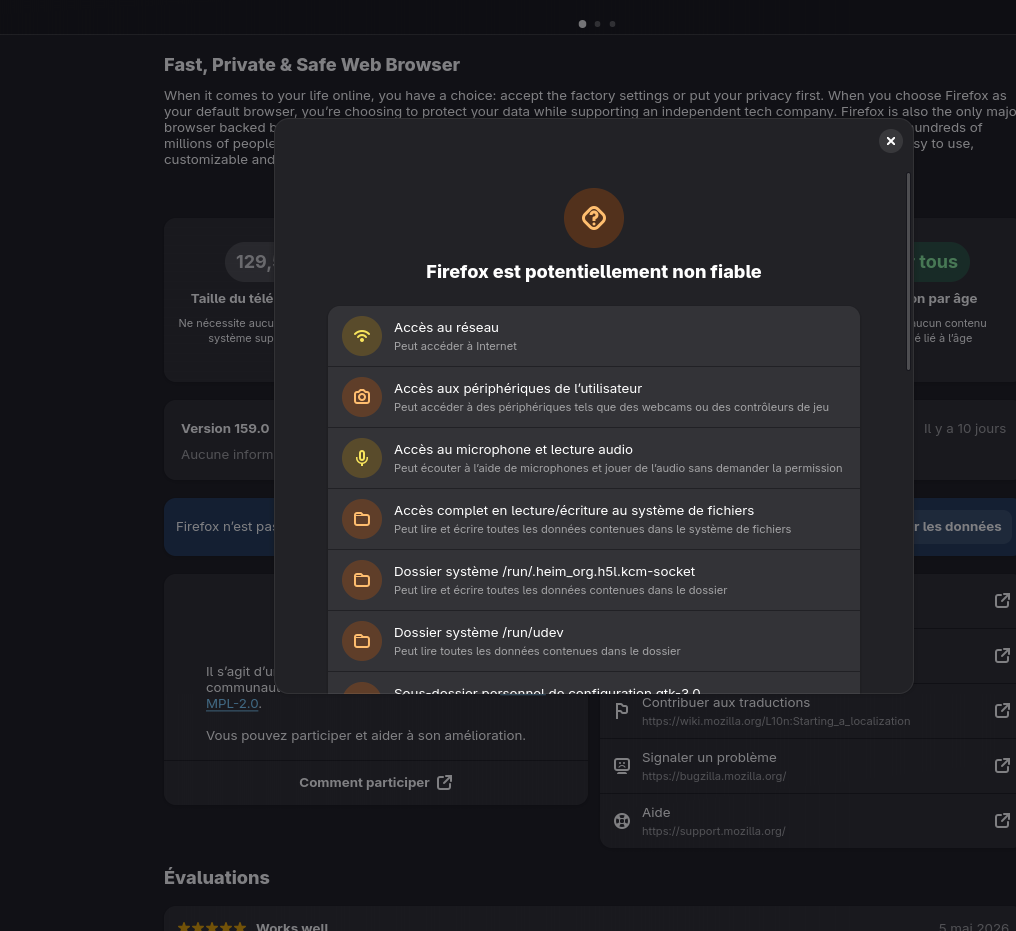
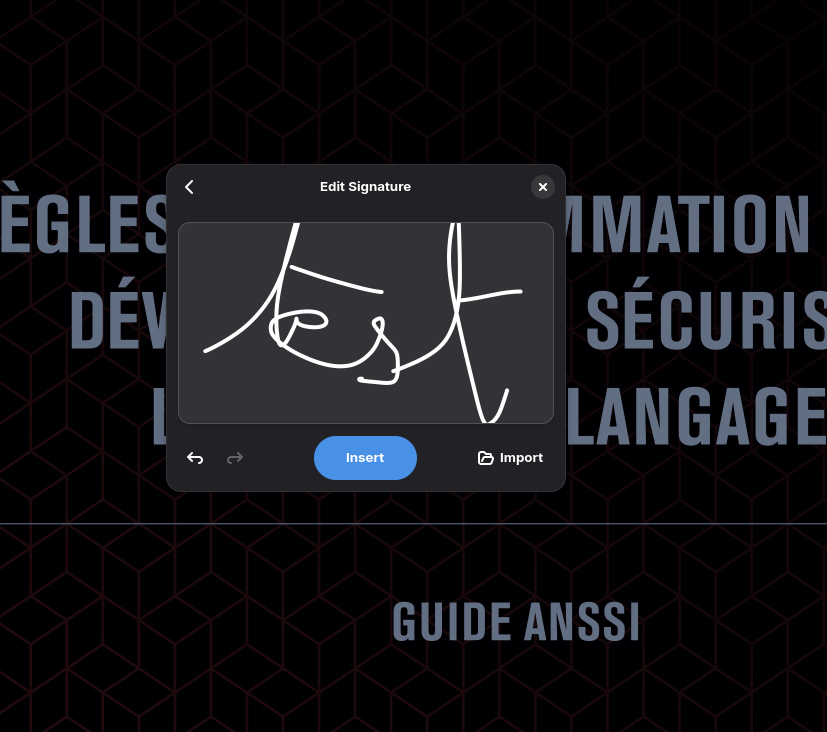
Expérience utilisateurL'environnement de bureau GNOME est proposé dans sa version 51. Comme souvent lors des précédentes versions, l'amélioration des performances et de l'affichage sont à l'honneur. La capture d'écran est notamment plus rapide en évitant des opérations redondantes ou de copie de l'image, Mutter a retravaillé son ordonnancement de l'affichage qui permet aux animations d'être fluides même en cas d'usage intensif de la machine. Les anciens pilotes propriétaires de Nvidia ne sont plus pris en charge : outre la simplification du code, cela rend le sous-système plus robuste et efficace pour les autres pilotes. Cela ne concerne que les pilotes propriétaires nommés version 470 et inférieurs, le pilote libre nouveau peut être utilisé à la place dans ce contexte. Enfin le curseur de souris peut être rendu au format vectoriel plutôt qu'une image bitmap pour s'assurer de la qualité du rendu. De même, les préférences bénéficient de nombreux changements. GNOME peut enfin tirer parti d'un éventuel accéléromètre pour effectuer une rotation automatique de l'affichage. Il est possible de bloquer cette rotation dans un sens particulier. Dans la même veine, il est possible de désactiver automatiquement le touchpad de l'ordinateur quand une souris externe est connectée. Côté sécurité, l'antique protocole de sécurité Wi-fi WEP n'est plus pris en charge tandis que les connexions distantes permettent d'utiliser un socket serveur SSH. L'interface pour l'enregistrement des empreintes digitales a été revue. Le magasin d'applications Logiciels démarre plus rapidement en exploitant le cache des usages précédents et avec un rendu des icônes amélioré pour rendre l'opération plus rapide. La liste des permissions requises par une application est maintenant entièrement visible avant d'installer la dite application. Enfin si vous souhaitez installer une application qui ne reçoit plus de mises à jour, une alerte vous préviendra avant d'effectuer l'opération. Le navigateur de fichiers n'est pas en reste, de nombreuses opérations longues comme une copie, un rafraichissement important, une recherche, etc. ne bloquent plus l'interface. Le rendu des gros dossiers ou des dossiers distants est également plus rapide. Les notifications de l'application sont également groupées. Tandis que le navigateur Web propose une génération automatique de mots de passe aléatoires, sécurisés et longs en reposant sur la bibliothèque pwquality pour s'assurer de la qualité du résultat. Le gestionnaire de mots de passe est également plus fiable. La barre d'adresse a été retravaillée pour que la suggestion des moteurs de recherche lors d'une saisie ne pollue pas trop la liste des possibilités. L'application Cartes permet enfin de télécharger les cartes d'une région pour effectuer un rendu hors ligne plus tard. Il affiche également beaucoup plus de données temps réel concernant les transports publics comme les départs ou arrivés à venir ou s'il y a du retard sur un trajet donné. Alors que l'application Calendrier se focalise sur l'amélioration de ses performances, en particulier pour la vue mensuelle avec un calendrier chargé. La synchronisation des calendriers consommera moins de données. L'intégration avec Cartes a été renforcée pour lancer ce dernier si un événement a une localisation précise. Enfin l'édition des événements a été revue qui bénéficie d'une plus grande section de notes et une meilleure prise en charge des liens des réunions sur Microsoft Teams. Le visionneur d'images Loupe affiche beaucoup plus de métadonnées de l'image, pendant que le prévisualiseur de documents a été porté sur GTK4 et libadwaita pour s'intégrer au reste de l'environnement tels que le mode sombre ou la prise en charge des affichages à haute densité de pixels. Enfin le visualiseur de documents Papers peut insérer des signatures effectuées avec la souris ou le touchpad. Passage de l'utilitaire GNOME Keyring à oo7 pour l'accès et la gestion des données privées, comme les mots de passe. Ce changement introduit par le projet GNOME permet d'améliorer la gestion des permissions avec des applications qui n'ont accès qu'à certaines informations qu'il contient, mais aussi des secrets FIDO2. Les données enregistrées par GNOME Keyring sont automatiquement migrées vers oo7 ce qui rend cette transition transparente pour l'utilisateur. Les versions atomiques bénéficient de l'interface web d'Anaconda pour l'installation du système. Cette nouvelle interface a été proposée dans Fedora Linux 42 pour l'édition Workstation. Ce changement permet d'avoir une procédure plus uniforme et de simplifier la maintenance de fait. Ces mêmes versions peuvent bénéficier de l'installation distante via HTTPS à titre expérimental. Cela est possible grâce à l'apport du point précédent. Pour des raisons de sécurité cela n'est pas actif par défaut, il suffit de renseigner parmi les arguments du noyau au démarrage de l'image Live les options inst.webui.remote.password=PIN où PIN est un code PIN à renseigner par la machine qui effectuera l'installation. Le fait de se passer des protocoles d'affichage distants tels que VNC ou RDP permet d'utiliser plus de périphériques différents pour procéder à l'installation avec une meilleure intégration en général dans le système. De plus, sur le système cible il y a besoin de moins de ressources pour cette opération ce qui est particulièrement avantageux pour installer des Fedora sur des cartes ARM64 peu puissantes. Le chiffrement permet d'éviter les fuites du mot de passe durant la procédure, le chiffrement reposant sur des certificats auto-signés générés à la volée.
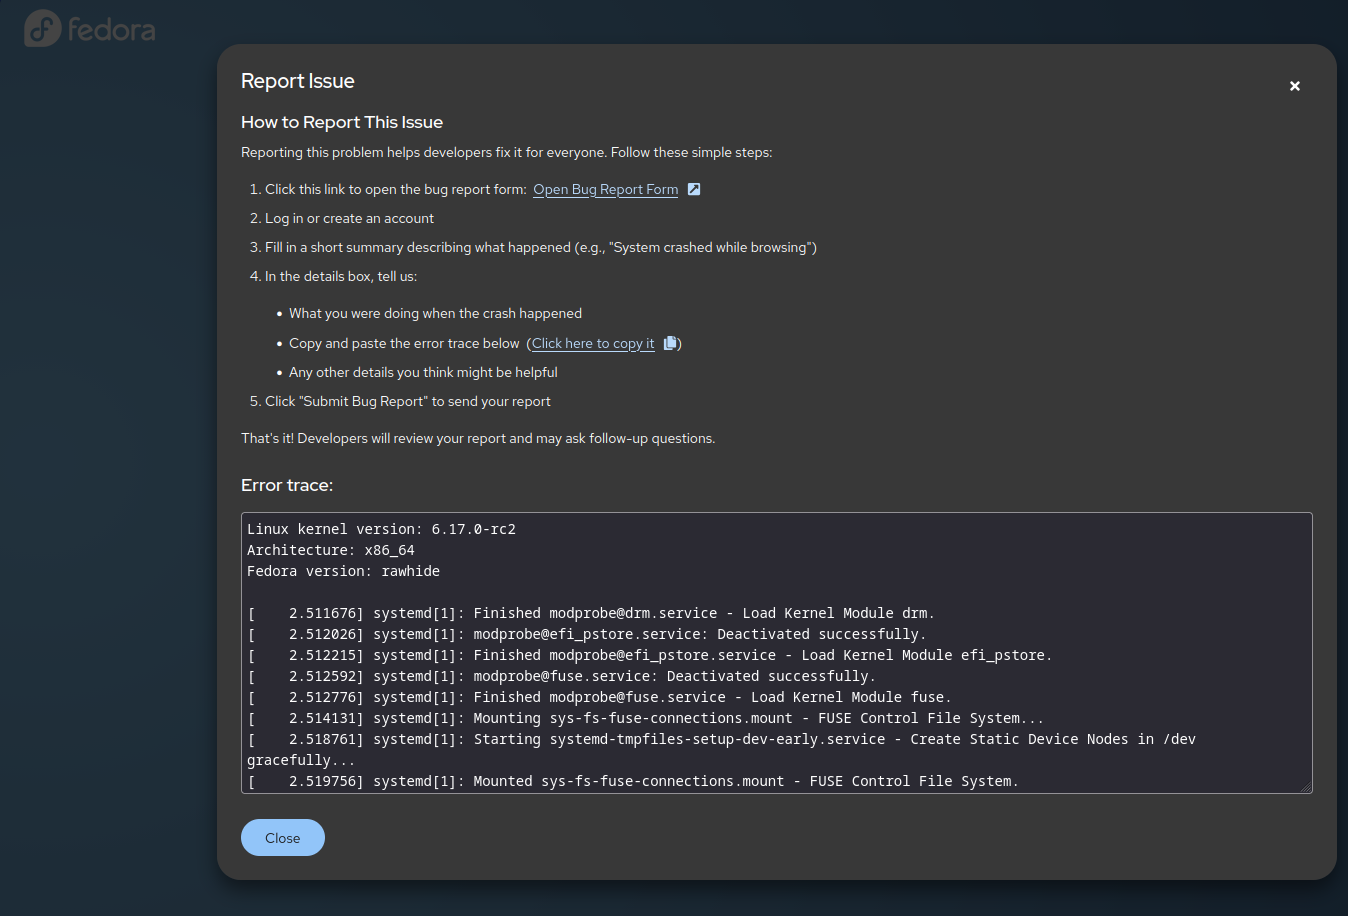
En cas de certaines erreurs fatales du noyau, le QR code d'erreur généré redirige vers le site https://drm-panic.fedoraproject.org/ pour expliquer plus simplement l'erreur rencontrée. En effet les QR codes précédents introduits depuis Fedora Linux 42 ne sont pas facilement exploitables par l'utilisateur moyen. L'objectif est que cette information soit affichée de manière plus structurée et lisible pour l'utilisateur et faciliter la création d'un rapport de bogue s'il le souhaite. Pour des raisons de confidentialité, les informations sont traitées localement sur la machine de l'utilisateur avec une implémentation purement en JavaScript. Les données ne sont envoyées à un éventuel serveur que si un rapport de bogue est crée à partir de ces informations. Le projet Fedora espère que la simplification de cette étape permettra de recueillir plus de rapports de bogue et d'améliorer l'aide entre utilisateurs. L'aide de LibreOffice repose maintenant sur des pages web ouvertes depuis un navigateur externe. C'est une option fournie par LibreOffice depuis quelques temps qui permet de s'affranchir de l'aide interne du logiciel. Ainsi ouvrir l'aide ouvrira le navigateur par défaut vers l'aide locale de LibreOffice. L'avantage pour Fedora Linux est de rendre les paquets de l'aide plus petits, mais aussi parce qu'ils ne dépendent plus du code même de LibreOffice, les paquets sont indépendants de l'architecture et n'ont pas besoin d'être dupliqués pour chaque plateforme ce qui fait gagner des ressources pour compiler et distribuer ces paquets en supprimant des redondances. Les dictionnaires fournis par le projet LibreOffice peuvent être installés en lieu et place de ceux du projet hunspell dont ils dérivent. Le métapaquet libreoffice-dictionaries permet d'installer les différents sous paquets libreoffice-dict-<lang>. Bien que LibreOffice utilise hunspell, de nombreux ajouts sont disponibles dans la variante de LibreOffice dont quelques langues supplémentaires ou une meilleure prise en charge des variantes de l'anglais avec un dictionnaire dédié pour chacune d'entre elles. Il n'est pas possible d'installer les deux dictionnaires en parallèle pour une même langue. Chaque édition atomique de Fedora Linux peut bénéficier de sa propre liste de Flatpak provenant de Flathub. Ce changement n'a pas encore un impact direct immédiat mais ouvre la porte à ce que chaque édition en fonction de ses besoins puisse arbitrer si un Flatpak provient par défaut de Fedora ou de Flathub. L'objectif est de trouver un équilibre pour avoir une logithèque Flatpak suffisamment fournie tout en utilisant les Flatpak de qualité voire officiels qui peuvent venir de Flathub ce qui est bénéfique pour l'utilisateur et le développeur de l'application. Le tout en permettant d'éviter les Flatpak de Flathub qui ne respectent pas les critères légaux du projet Fedora notamment vis à vis des brevets logiciels ou de licence par exemple.
InternationalisationL'outil d'aide à la saisie IBus évolue à la version 1.5.35. Il prend en charge les états ISO des disposition clavier XKB tels qu'utilisés par les environnement KDE Plasma, Sway, Hyprland ou COSMIC. Cela permet par exemple pour une disposition lituanienne en tapant `a d'obtenir ā au lieu de `a. Par ailleurs il gère également le forward key events du protocole Wayland input-method version 2 pour rediriger les événements clavier de la pop-up IBus vers le moteur IBus. Mise à jour de fontconfig à la version 2.18. Le cache des polices passe à la version 11 qui précise quelle version de fontconfig a généré le dit fichier ce qui permet plus facilement d'être réutilisé sans devoir les régénérer ce qui est particulièrement utile en cas d'usage partagé tels que des environnements à base de conteneurs ou d'applications dans des bacs à sable. Un nouvel outil fc-genconf fait son apparition pour générer une configuration basique. Administration systèmeNetworkManager prend en charge les réseaux IPv6-mostly. Derrière cette terminologie surprenante se cache la RFC 8925 déjà implémentée dans d'autres systèmes d'exploitation concurrents dont l'objectif est d'assurer une transition douce vers un réseau uniquement IPv6. Un réseau IPv6-mostly permet de partager au sein d'un même réseau des machines IPv6 uniquement, IPv4 uniquement et ceux ayant une double pile tout en partageant le même segment. Côté NetworkManager cela consiste dans la prise en charge de deux protocoles : DHCPv4 option 108 (RFC 8925) et 464XLAT (RFC 6877). Le premier permet à l'administrateur du réseau de forcer le passage à l'IPv6 uniquement pour un périphérique donné qui peut ainsi couper l'IPv4 automatiquement. Le second comporte deux parties, une côté client nommée Customer-side translator (CLAT) qui permet de traduire un paquet IPv4 généré par une application du système en un paquet IPv6 avant de l'envoyer sur le réseau. Cela permet donc à une application non conçue pour l'IPv6 de malgré tout envoyer des données à un service en ligne qui ne prend en charge que l'IPv6. Côté réseau, en dehors de ce que NetworkManager doit gérer, il peut y avoir ajout de Provider-side translator (PLAT) qui utilise NAT64 pour convertir le paquet IPv6 en paquet IPv4 avant de l'envoyer sur un autre réseau dont Internet. Ainsi la combinaison des deux parties permet également à une application utilisant IPv4 d'atteindre un service IPv4 sur Internet tout en ayant un principalement un réseau local IPv6. Ou à un système utilisant uniquement IPv6 de malgré tout communiquer avec des services IPv4 sur Internet. Par défaut et pour des raisons de sécurité, l'API noyau ptrace n'autorisera plus certains accès à moins d'installer certains logiciels comme un débogueur qui peuvent en avoir besoin. En effet cet API permet à un processus d'inspecter et de contrôler un autre processus lancé par le même utilisateur ce qui permet notamment d'investiguer dans sa mémoire ou de changer son flux d'exécution. Cependant cette capacité est intéressante dans le cadre du développement en particulier pour certains outils comme les débogueurs. Linux a introduit par le passé un module nommé yama pour trouver un compromis. Ainsi cette inspection n'est possible que depuis le processus qui en a lancé un autre, ce que fait notamment un débogueur. C'est la politique par défaut de Linux et largement suivie parmi les distributions. Fedora Linux a fait le choix, comme Debian, de désactiver ce module yama dans certains contextes pour autoriser cet usage dans d'autres contextes de développement en liant cette désactivation au paquet elfutils-libs entre autres. Et par le jeu des dépendances, il était en fait en permanence désactivé dans tous les systèmes Fedora Linux depuis lors. L'objectif ici est donc de changer cela pour que le paquet yama-ptrace-enable, qui active ptrace, ne soit installé que si l'un des paquets suivant est installé : elfutils, systemtap, gdb (mais pas gdb-headless ou gdb-minimal), lldb, delve, strace, ltrace, etc. ce qui n'est pas le cas par défaut et doit améliorer la sécurité de beaucoup de systèmes Fedora Linux. Les utilitaires chpasswd et newusers utilisent dorénavant PAM pour valider les droits et si les mots de passe sont conformes à la politique de sécurité du système. Ainsi ces outils peuvent tenir compte si un nouveau mot de passe réutilise un mot de passe précédent, ne pas autoriser un mot de passe trop faible selon des critères définis, de notifier dans les logs si les mots de passes ont été changés, etc. Cela est conforme au fonctionnement des autres utilitaires qui passent par PAM pour ces tâches ce qui uniformise leur comportement dans le système. Les consoles virtuelles passent de fbcon à kmscon. Ainsi la gestion de ces consoles virtuelles passe du noyau Linux à l'espace utilisateur. Le premier n'est plus trop maintenu car reposant sur l'ancienne interface frame buffer plutôt que d'utiliser l'interface drm. De fait, comme les pilotes graphiques actuels reposent majoritairement sur l'interface drm, l'usage de fbcon nécessite une couche d'émulation nommé fbdev et l'usage des utilitaires bash et getty pour avoir un fonctionnement basique. Et encore, le scroll à la souris restait désactivé pour des raisons de sécurité du fait du manque de maintenance. kmscon remplace cela en utilisant les couches modernes du noyau ce qui améliore la sécurité et la fiabilité en tournant en espace utilisateur. Ainsi en cas de crash, le service est redémarré plutôt que de planter entièrement la machine avec un kernel panic. Le tout en offrant plus de fonctionnalités, ainsi il propose le scroll de la souris évoqué précédemment, la prise en charge de xkbcommon pour mieux gérer les dispositions claviers et permettre d'en changer à la volée, un rendu des caractères avec une meilleure compatibilité avec Unicode, la possibilité d'avoir une accélération graphique reposant sur OpenGL. Le copier/coller à la souris tout comme la rotation de l'écran sont aussi disponibles. En cas de problèmes sur une machine, un retour en arrière automatique vers fbcon est proposé ou reste possible manuellement. Mais à terme l'objectif est d'abandonner entièrement ce dernier. Pour ceux qui sont intéressés de configurer kmscon, il est possible d'éditer le fichier /etc/kmscon/kmscon.conf. Déplacement des fichiers des dépôts de la distribution du répertoire /etc/yum.repo.d vers le répertoire /usr/share/dnf5/repos.d. Les clés GPG sont aussi redirigées vers le fichier /usr/share/pki/rpm-gpg. Cette opération a été rendue possible par la suppression complète de DNF4 dans la version précédente de Fedora Linux ce qui a simplifié les choses. L'objectif est de tirer partie de la séparation entre configuration système et utilisateur de plus en plus adoptée avec une configuration en lecture seule fournie par la distribution dans /usr quand les changements sont effectués sur /etc/ pour mieux distinguer ce qui est fourni par la distribution et ce qui est changé. Ainsi l'utilisateur qui souhaite ajouter des dépôts à la main peut continuer à utiliser /etc/yum.repo.d et s'il veut changer les paramètres d'un dépôt existant il peut le faire dans le dossier /etc/dnf/repos.override.d/. Anaconda prend en charge le gestionnaire de stockage Stratis. Pour rappel il permet de fusionner la couche bloc et le système de fichiers XFS pour fournir des fonctionnalités supplémentaires clé en main telles que les snapshots ou le chiffrement le tout via une interface en ligne de commande et une interface DBus spécifique. La nouveauté comprend l'installation via un fichier kickstart tout comme le partitionnement manuel. Stratis était certes proposé depuis Fedora 28 mais l'absence de disponibilité à l'installation par défaut a réduit son adoption potentielle car il était nécessaire de l'installer après coup par des moyens détournés ou l'utiliser pour d'autres partitions que celle du système. L'objectif ici est d'y remédier pour attirer de nouveaux utilisateurs intéressés par la solution. Le logiciel Ignition gère le format de configuration de l'outil Butane. Ignition est le logiciel qui permet de configurer l'espace disque et les utilisateurs lors du premier démarrage de CoreOS à partir d'une configuration. Cependant son fichier de configuration au format JSON est jugé difficile à manipuler par un humain. D'où la création de Butane qui permet d'avoir une configuration plus simple à écrire au format YAML qu'il peut transpiler par la suite pour fournir le résultat obtenu à Ignition. Cependant cette approche en deux temps où il faut au préalable installer butane pour écrire la configuration en YAML puis le transpiler avant de l'envoyer à Ignition complexifie le système et ajoute des barrières d'entrée à l'usage de CoreOS. Ignition a absorbé le code de Butane mais l'utilitaire Butane reste toujours disponible dans son paquet dédié. Ignition va tenter de parser d'abord au format YAML avant de tenter de le parser comme une configuration JSON si cela avait échoué. Les configurations source: local / --files-dir ne sont pas gérées au lancement de CoreOS car d'autres fichiers nécessitent d'être présents pour cela, cela nécessite de passer par l'utilitaire butane sur un autre système au préalable.
L'API noyau de cryptographie à destination de l'espace utilisateur est partiellement désactivée. Cette API est difficile à maintenir et pose de gros problèmes de sécurité. Le projet Linux lui même entame le processus de s'en passer à terme. Le projet Fedora décide de prendre les devants, ainsi dès la version 7.2 du noyau proposée par Fedora Linux 45, les algorithmes disponibles via cette API sont restreints par défaut mais cette restriction peut être levée en changeant la valeur du fichier /proc/sys/crypto/af_alg_restrict. Cette restriction n'arrivant normalement qu'à partir de la version Linux 7.3. Le projet Fedora souhaite mettre un terme entièrement à cette API pour Fedora Linux 46 quoi que décide le projet Linux d'ici là. L'usage de cette API est officiellement faible, peu de paquets de Fedora Linux s'en servent encore dont certains qui ne sont plus trop maintenus comme iwd avantageusement remplacé par wpa_supplicant. L'objectif est d'avertir ici les potentiels utilisateurs de solutions maisons de s'y préparer et d'engager la transition pour les quelques paquets qui s'en servent encore avant une suppression définitive. L'outil d'authentification authselect ne propose plus la prise en charge les profils NIS par défaut. Il n'est plus possible de choisir NIS pour nsswitch.conf avec la commande authselect select nis mais l'option reste disponible via un profile personnel ou des opérations manuelles. L'objectif est de réduire l'usage de cette technologie dépassée au sein de Fedora Linux pour s'affranchir de sa maintenance à terme. Mise à disposition de l'outil encapsule pour exécuter des outils venant d'Internet dans un conteneur léger dédié. Cet outil en ligne de commande est conçu pour exécuter les scripts ou utilitaires usuellement téléchargés à coup de curl <url> | sh, npm install <paquet> et autres dans un environnement plus isolé du système pour limiter les risques de sécurité ou tout simplement de pollution du répertoire utilisateur. Il repose sur Podman pour concevoir le conteneur qui l'exécute et a une configuration simple pour désactiver le réseau ou les droits super utilisateurs par exemple. Il n'est pas impossible à terme qu'il devienne un wrapper à OpenShell dans le futur pour apporter une isolation plus forte encore pour des raisons de sécurité. Ajout de grub-cc comme chargeur de démarrage minimal pour démarrer sur des machines en UEFI uniquement pour lancer des images noyau unifiés (UKI). C'est une alternative à GRUB lui même pour ce cas d'usage à destination des conteneurs comme ceux pour du Confidential Computing, d'où le nom, CoreOS ou les machines virtuelles. L'objectif est de réduire sa taille en ayant uniquement le strict nécessaire pour fonctionner dans ce contexte. Cela permet de réduire la surface d'attaque mais aussi le nombre de mises à jour potentielles, chacune nécessitant de le resigner sur la machine dans le cadre du Confidential Computing. L'utilitaire des paquets rpm passe à la version 6.1. Pour les utilisateurs, il est possible d'effectuer des requêtes pour notamment connaître les paquets installés sur le système même si une transaction, comme l'installation d'un paquet, est en cours. Avant chaque transaction bloquait ce type de requêtes en lecture seule. La recherche des groupes et utilisateurs peut de nouveau passer par Name Service Switch ce qui est particulièrement utile en cas d'authentification centralisée comme dans les grandes entreprises. Le temps d'installation d'un paquet devrait être plus rapide. Les autres ajouts sont plutôt destinés aux créateurs de paquet comme les modificateurs de macros litéraux afin de ne pas interpréter les % d'une macro ou one shot pour résoudre une macro qu'une fois afin de réutiliser son résultat par la suite pour obtenir des gains de performances. La macro %define peut résoudre une macro immédiatement durant sa définition ou mettre la macro dans le contexte global indépendamment. La commande rpmbuild peut aller directement aux étapes %check avec l'argument --short-circuit pour gagner du temps durant le développement. Enfin le script d'environnement de construction est généré dans le fichier rpmbuild.env dans le répertoire %{builddir} afin de faciliter le débogage, son analyse ou pour reproduire les différentes étapes manuellement. Ce dernier rend obligatoire par défaut la vérification des signatures des paquets avant leur installation. Si un paquet n'est pas signé ou que la signature n'est pas correcte, l'installation échouera. Ce mode était déjà présent depuis les débuts de Fedora dans YUM puis DNF, l'objectif est que l'outil sous-jacent RPM suive cette directive pour des raisons de sécurité qui sont plus prégnantes de nos jours qu'à l'époque. Il est possible de la désactiver avec l'option --nosignature. Il a été nécessaire d'attendre depuis RPM 6.0, disponible depuis Fedora Linux 43, qui offrait déjà cette possibilité avec des aides pour générer des paquets auto signés par ailleurs car l'équipe manquait de ressources pour les adaptations nécessaires. Car en effet il n'était dès lors plus possible pour DNF d'installer des paquets non signés à la demande dans ce cas, et il fallait vérifier la construction des paquets pour adapter les procédures afin que cela soit possible sans encombre et sans multiplier les désactivations manuelles ci et là. La bibliothèque de sécurité OpenSSL est mise à jour vers la version 4.0. Comme souvent la version majeure de cette bibliothèque de référence est l'occasion de casser la compatibilité ascendante. C'est pourquoi la version 3 reste disponible via le paquet openssl3 pour les logiciels et ceux qui en ont encore besoin. Ainsi, il propose une meilleure confidentialité avec la prise en charge de Encrypted Client Hello (ECH) pour chiffrer l'initialisation des échanges TLS et cacher le Server Name Indication durant le processus. Il améliore également la prise en charge de la cryptographique dite post-quantique notamment avec l'implémentation de la RFC 8998. Côté suppression, beaucoup de code d'anciens algorithmes de chiffrement sont retirés après une longue période de désactivation comme SSLv3. Le gestionnaire de conteneurs podman est proposé dans sa 6e version. Cette version majeure nécessite aussi certaines adaptations avec la suppression de slirp4netns qui est remplacé par pasta pour la réalisation de réseau sans droits superutilisateurs. La prise en charge des cgroups version 1 est également supprimée tout comme la base de données BoltDB qui était déjà remplacée par défaut par SQLite depuis la version 4.8. Pour assurer une bonne migration des données, il est conseillé de mettre à jour vers podman 5.8 qui est disponible dans les autres versions de Fedora Linux avant. Du côté des fonctionnalités, les fichiers de configurations ont été revus pour retirer la confusion entre les paramètres pour les clients distants et ceux des serveurs avec le partage d'une logique similaire entre les fichiers containers.conf et storage.conf. Pour le réseau, la création de réseau va utiliser Netavark qui perd par ailleurs la prise en charge d'iptables au profit de nftables. L'ordre des interfaces réseau est maintenant aussi préservé au sein des conteneurs. La version par défaut du gestionnaire de base de données MySQL pointe vers la version 9.7 au lieu de la version 8.4. Cette version apporte notamment le nouveau type pour les colonnes : VECTOR qui est un ensemble de flottants 4 de octets. De par la nature de la colonne, elle ne peut pas être utilisée comme clé primaire de la table par exemple. Elle sert de base technique à la solution MySQL HeatWave qui sert dans un contexte d'IA pour notamment faire de la recherche au sein de documents. Certaines fonctions comme le calcul de distance entre deux vecteurs sont proposées à cette fin. De plus, l'optimiseur de requêtes Hypergraph fait son entrée pour proposer, en général, de meilleures performances. De même plusieurs modules de télémétries et de réplications pour effectuer de la haute disponibilité sont disponibles pour permettre notamment une meilleure compatibilité avec des solutions OpenTelemetry. Pour des raisons de sécurité, le greffon mysql_native_password tire sa révérence pour l'authentification. Il est nécessaire de reconfigurer les authentifications pour employer caching_sha2_password à la place par exemple. La version 8.4 reste disponible avec le paquet mysql8.4 pour ceux qui en ont besoin. De manière analogue, la version par défaut du gestionnaire de base de données MariaDB pointe vers la version 12.3 au lieu de la version 11.8. Cette version apporte de nombreuses fonctions pour améliorer la compatibilité avec la solution propriétaire Oracle dont la prise en charge native de SYS_REFCURSOR ou des triggers qui peuvent être exécutés individuellement sur plusieurs événements à la fois ce qui simplifie la maintenance par ailleurs. L'optimisateur de requêtes bénéficie aussi de nombreuses optimisations, et a ajouté la prise en charge de nombreuses indications d'optimisation proposées par MySQL pour améliorer la compatibilité entre les deux. Pour améliorer la compatibilité avec MySQL, il implémente aussi la fonction d'authentification caching_sha2_password évoquée plus haut. Enfin les données géospatiales bénéficient d'une meilleure prise en charge avec des fonctions pour valider et vérifier la validité de ces données, pour simplifier les géométries complexes afin d'améliorer les performances ou encore les hasher pour effectuer des recherches de proximité performantes. Les versions 10.11 et 11.8 restent disponibles via les paquets mariadb10.11 et mariadb11.8 pour ceux qui le souhaitent. DéveloppementLa chaine de compilation GNU progresse avec binutils 2.47 et glibc 2.44. Les utilitaires binutils prennent en charge de nombreuses extensions du standard de l'architecture RISC-V. L'assembleur introduit une nouvelle commande --reloc-section-sym=[all|internal|none] pour spécifier si les relocalisations faisant référence à des symboles de liaison locale sont ajustés pour utiliser les sections des symboles. objdump et readelf peuvent préciser un répertoire où trouver des fichiers de débogage supplémentaires avec --debug-dir=[DIR]. Enfin l'éditeur de lien bfd peut fonctionner avec une optimisation faible avec l'argument -O 0 ce qui bloque la fusion du contenu des sections pour diminuer le temps de l'opération au détriment de la taille du binaire final. La bibliothèque C glibc introduit le fichier /etc/tunables.conf pour stocker les réglages de manière plus permanente et simple que l'emploi de la variable d'environnement GLIBC_TUNABLES. La configuration consiste en un paramètre par ligne. De nombreuses optimisations et corrections des fonctions mathématiques ont également été importées du projet CORE-MATH. La chaine de compilation LLVM version 23 est proposée. Cette version comme souvent apporte une prise en charge partielle de la prochaine norme C++2d et de la future norme C2Y tandis que les normes antérieures du C et C++ sont mieux gérées. Les diagnostiques pour ces langages bénéficient de nombreuses améliorations dont des alertes en lien avec la durée de vie des objets ou pointeurs manipulés par des fonctions. Il apporte notamment aux architectures ARM64 et x86_64 la fonction Lightweight Fault Isolation pour réaliser un bac à sable léger pour les applications C et C++ afin de réduire les risques de sécurité autour des problèmes mémoires de ces applications sans trop pénaliser les performances et sans demander beaucoup d'adaptations. Côté matériel il propose un début de la prise en charge du prochain processeur Nvidia nommé Rosa. Du côté d'AMD, c'est l'interface de programmation AMD HIP, proche de Nvidia CUDA pour l'exploitation des capacités de calcul sur GPU, qui utilise le nouveau pilote de LLVM pour s'y interfacer, rejoignant ainsi Nvidia CUDA et OpenMP qui en bénéficiaient déjà. Et comme la suite GNU évoquée plus haut, de nombreuses instructions RISC-V sont prises en charge par l'assembleur maison.
Le langage Python rampe vers la version 3.15. Cette version apporte l'import paresseux des modules avec le mot clé lazy pour ne charger un gros module que s'il est réellement utilisé afin d'améliorer les performances quand le module n'est pas utilisé finalement. Des dictionnaires immuables frozendict étendent la liste des objets de base immuables pour apporter plus de garanties dans le code notamment dans un contexte d'exécution parallèle. Les outils de profilage de code sont rassemblés au sein du module profiling qui bénéficie d'un nouveau profiler Tachyon. Celui-ci effectue des mesures à intervalles réguliers pour diminuer le coût de son usage tout en ne nécessitant pas de changement dans le code. Mais cela au détriment de l'exactitude du résultat. Enfin, le compilateur JIT expérimental bénéficie de nombreuses améliorations de performance. La bibliothèque python-dateutil est marquée comme dépréciée en vue d'une suppression future. Cette extension de la fonction datetime de Python n'est plus maintenue ce qui peut poser à terme des problèmes de sécurité alors que de nombreux projets en dépendent encore. L'objectif est d'évaluer la situation et de commencer la transition où elle est possible avant d'entamer sans suppression quand la transition sera terminée ou sa maintenance impossible. L'utilitaire Python setuptools est proposé avec la version 82. Cette version n'est pas compatible avec la précédente notamment à cause de la suppression de pkg_resources qui a été remplacé par importlib.resources et importlib.metadata depuis déjà cinq ans. Fedora propose le paquet python3-pkg-resources pour fournir cette fonction manquante à part le temps d'effectuer la transition, près de 150 paquets de Fedora Linux en ont typiquement encore besoin. Le langage Go saute vers sa version 1.27. Cette version du langage propose les méthodes génériques qui étaient l'étape logique après l'introduction des fonctions génériques dans les versions précédentes. Le compilateur peut rediriger vers des allocateurs spécifiques les allocations de petites tailles afin d'améliorer jusqu'à 30% les performances dans ce contexte. Le détecteur de blocages dans les goroutines abandonne son statut expérimental pour être pleinement exploitable. Les paquets pour la prise en charge du encoding/json/v2 et encoding/json/jsontext sont introduits dans la bibliothèque standard. Le premier, afin notamment d'être plus strict concernant la validité d'un fichier JSON tout en améliorant les performances lors du parsage. Le second pour permettre une manipulation bas niveau et syntaxique du format. Un paquet uuid a été introduit pour générer ou lire facilement des identifiants uniques suivant différents formats. Enfin, le paquet expérimental simd est proposé pour effectuer des opérations parallèles variées de manière portable et indépendante de la taille des vecteurs afin d'améliorer les performances pour les opérations qui s'y prêtent. Le langage Perl brille dans sa version 5.44. Cette version propose une prise en charge d'Unicode 17.0, dont les règles ont été renforcées sur les identifiants et les noms de groupe des expressions régulières. D'ailleurs, les expressions régulières bénéficient d'une fonctionnalité expérimentale use feature "enhanced_xx" pour autoriser les classes de caractères entre crochets sous le modificateur /xx sur plusieurs lignes tout en pouvant contenir des commentaires. Le générateur interne de nombre aléatoires exploite l'appel système getentropy(), utilisant le fichier /dev/urandom ou un état interne si cela n'est pas possible. Les performances ont également été améliorées pour les opérations de base sur les entiers tout comme la génération d'un hash d'une liste de paires de clé / valeur. L'interpréteur Lua est mis à jour vers la version 5.5. Parmi les changements, il propose la déclaration de variables globales avec le mot clé global, les vararg tables peuvent être nommés, les tableaux sont plus compactes pouvant être jusqu'à 60% plus petits en mémoire et de meilleures performances pour le ramasse miettes. La variable utilisée pour itérer dans la boucle for est également en lecture seule maintenant. La boîte à outils Ruby en Rails roule vers sa version 8.1. Il propose notamment la possibilité de reprendre des longues tâches en les découpant en étapes plus petites, permettant de reprendre à la dernière étape complètement effectuée plutôt que depuis le début si jamais la procédure a été interrompue. Une nouvelle interface Rails.event permet de structurer les événements pour être plus facilement analysés par des outils. Pour les développeurs il est possible de définir sa machine comme une instance pour lancer des tests d'intégration continue avec le binaire bin/ci. Enfin il permet de faire un rendu ou répondre à une requête directement depuis le format Markdown dans les différents contrôleurs. Le générateur de protocoles protobuf passe à la version 6 et 5 pour respectivement le C++ et le C. Cette version introduit plus de modularité avec Bzlmod pour proposer un cœur plus réduit et plein de modules autour afin de simplifier la maintenance du projet. Cela peut simplifier l'import de modules externes par ailleurs. Ce changement pourrait simplifier la mise à niveau des adaptateurs pour les différents langages à l'avenir. Le paquet protobuf3 est toujours proposé à des fins de compatibilité, le format v3 du protocole ayant été supprimé dans ces nouvelles versions. Le langage fonctionnel Erlang évolue vers la version 27. La syntaxe du langage autorise les commentaires multilignes et sans le besoin d'échappement grâce au délimiteur """ pour simplifier leur écriture. De manière analogue, il est possible de définir une chaine de caractères littérale sans caractères d'échappements avec le sigils ~B pour débuter la dite chaine de caractère qui est entre crochets. Le nouvel encodeur JSON est proposé afin d'améliorer les performances. Niveau performances, le client SSL peut aussi vérifier la signature du résultat de la réponse signée de l'OCSP d'un serveur pour vérifier si la clé a été révoquée ou non par le CA sans devoir effectuer des requêtes supplémentaires. Enfin à des fins de débogage ou de traçabilité il est possible de nommer les processus afin de savoir à quoi ils correspondent. La bibliothèque d'analyse de données Pandas pousse à sa version 3. Cette version propose un nouveau type native pour les chaines de caractères plutôt que de reposer sur le type objet générique de Python qui n'est pas suffisamment spécifique ni performant pour cet usage. Le comportement du copy-on-write a changé, les opérateurs retournant un sous-ensemble ou une indexation d'une série de données fonctionnent comme une copie de l'objet original, nécessitant de manipuler directement l'objet original si on souhaite le modifier. Cela rend le comportement plus cohérent mais améliore aussi les performances. De nombreuses fonctions obsolètes ont été définitivement supprimées avec cette version, la rendant non rétrocompatible. La bibliothèque xmlsec parse sa version 1.3. Cette version n'est pas non plus rétrocompatible avec la précédente. Elle propose un nouveau type KeyInfoReference pour permettre à plusieurs signatures de faire référence à la même chaine de validation au lieu d'avoir une copie entière pour chacune en mémoire. La recherche par clé est devenue plus stricte, uniquement les clés référencées dans KeyInfo sont considérées. La prise en charge du protocole FTP a été supprimée de même que la fonction de hashage md5 toutes deux pour des raisons de sécurité. L'environnement de développement de Free Pascal nommé Lazarus dispose d'une interface graphique GTK3, Qt5 ou Qt6, en plus de GTK2 jusqu'alors proposée. Pour cela des sous-paquets ont été introduits tel que lazarus-ide-gtk3 qui ne sont pas installables en parallèle. Cela permet de proposer les différentes possibilités d'intégration de ce logiciel selon le goût de ses utilisateurs. Il permet aussi d'envisager le retrait à terme de la variante GTK2 quand cette bibliothèque obsolète sera entièrement retirée du système. La configuration des pilotes ODBC, pour la création d'API pour les gestionnaires de base de données, a été scindée pour améliorer la modularité de ce fichier. Le fichier /etc/odbcinst.ini fait notamment le lien entre un module et la bibliothèque dans le système qui permettait de s'en servir et jusqu'ici tous les pilotes supportés étaient présents dans le fichier. Le fichier était proposé par le paquet unixODBC. Mais à cause du découplage entre le pilote et cette configuration, présent dans des projets et paquets différents, la configuration contenait souvent des informations fausses. Et ce n'était pas évident pour les empaqueteurs de ces bibliothèques de devoir intervenir sur ce fichier aussi s'ils changeaient quelque chose dans leur propre paquet. De plus, le fichier pouvait indiquer comment se servir d'un pilote qui n'est pas présent sur le système ce qui pouvait facilement mener à des erreurs. Maintenant les fichiers de configuration sont installés dans le dossier /usr/lib/odbc/odbcinst.d, avec un fichier par gestionnaire de base de données qui n'est installé que si le pilote correspondant est installé également. Chaque installation ou suppression permet de générer ainsi le fichier /etc/odbcinst.ini final avec les bonnes informations. Il est d'ailleurs possibles pour les administrateurs systèmes d'adapter la configuration en créant des fichiers analogues dans /etc/odbc/odbcinst.d/ qui auront la priorité. Nodejs a maintenant un métapaquet nodejs non versionné. Ce paquet non versionné sert à installer l'une des versions de Nodejs disponible dans Fedora Linux pour un utilisateur qui n'accorde pas trop d'importance à la version exacte. La version réellement installée est choisie par les mainteneurs et peut changer au gré des versions de Fedora Linux. Installer le paquet versionné tel que nodejs22 apporte la garantie qu'une mise à niveau de Fedora Linux n'aboutira pas à un changement de version de nodejs, à moins que le paquet ne soit évidemment supprimé et dans ce cas la transition est laissée à la charge à l'utilisateur.
Projet FedoraLes images atomiques à usage bureautique sont construites avec l'utilitaire image-builder. L'objectif est de se passer de lorax qui effectuait cette tâche jusqu'ici ce qui permettra à terme de s'en passer totalement pour simplifier l'infrastructure et les méthodes de production des différentes images. Ces images reposent en un fichier boot.iso au sein d'un commit ostree ce qui est très proche des images Fedora IoT qui utilisaient déjà image-builder, rendant l'opération possible. Un autre bénéfice de cette migration est de permettre de générer des images au format qcow2 pour un usage pour machines virtuelles, ou une image raw pour l'architecture aarch64 afin de démarrer directement dessus avec l'outil arm-image-installer pour l'installer sur des petites cartes à architecture ARM. Le paquet libgit2 bénéficiera de plusieurs paquets avec des versions distinctes pour pouvoir les installer en parallèle. Le paquet au nom générique disparaît pour faire place à libgit2_1.9. Ce composant utilisé par une trentaine de paquets n'a pas une ABI stable même pour des versions mineures. Cela peut rendre la gestion délicate au sein du projet Fedora pour ne pas avoir de conflits tout en ayant un résultat stable. En particulier par la présence de bibliothèques d'adaptation comme en Python qui évoluent à des rythmes différents langage par langage. Si pour l'instant une seule version de libgit2 est proposée, la voie est tracée pour en avoir plusieurs en parallèle. Les variables non standards de CMake sont supprimées de la macro %cmake. Les variables *_INSTALL_DIR, SHARE_INSTALL_PREFIX et LIB_SUFFIX étaient passées par défaut par la macro %cmake alors que ces variables n'ont jamais été standards au sein de CMake. Chaque usage était donc spécifique à chaque logiciel avec parfois des confusions comme savoir si INCLUDE_INSTALL_DIR exigeait un chemin absolu ou relatif. Depuis CMake 3, les chemins d'installation standards sont définis dans GNUInstallDirs et son usage s'étend ce qui rend pertinent de pousser à migrer les paquets restants. Cela concernait tout de même environ 300 paquets sur les 2000 utilisant CMake. Ajout de la macro %openpgpverify pour effectuer les vérifications de signatures d'artéfacts avec Sequoia en remplacement de %gpgverify qui utilise GnuGP. En effet depuis 2023, GnuGP suit un protocole incompatible avec OpenGPG nommé LibrePGP. L'objectif est d'utiliser une alternative compatible avec le standard OpenPGP ce qui est le cas de Sequoia déjà employé par RPM ou podman par ailleurs. Il permet également l'usage d'algorithmes post-quantique notamment par la prise en charge de la RFC 9980. La communauté francophoneL'association
Borsalinux-fr est l'association qui gère la promotion de Fedora dans l'espace francophone. Nous constatons depuis quelques années une baisse progressive des membres à jour de cotisation et de volontaires pour prendre en main les activités dévolues à l'association. Nous lançons donc un appel à nous rejoindre afin de nous aider. L'association est en effet propriétaire du site officiel de la communauté francophone de Fedora, organise des évènements promotionnels comme les Rencontres Fedora régulièrement et participe à l'ensemble des évènements majeurs concernant le libre à travers la France principalement. Si vous aimez Fedora, et que vous souhaitez que notre action perdure, vous pouvez :
Nous serions ravis de vous accueillir et de vous aider dans vos démarches. Toute contribution, même minime, est appréciée. Si vous souhaitez avoir un aperçu de notre activité, vous pouvez participer à nos réunions mensuelles chaque premier lundi soir du mois à 20h30 (heure de Paris). Pour plus de convivialité, nous l'avons mis en place en visioconférence sur Jitsi. La documentationDepuis juin 2017, un grand travail de nettoyage a été entrepris sur la documentation francophone de Fedora, pour rattraper les cinq années de retard accumulées sur le sujet. Le moins que l'on puisse dire, c'est que le travail abattu est important : près de 90 articles corrigés et remis au goût du jour. La synchronisation du travail se passe sur le forum. Si vous avez des idées d'articles ou de corrections à effectuer, que vous avez une compétence technique à retransmettre, n'hésitez pas à participer. Comment se procurer Fedora Linux 45 ?
Si vous avez déjà Fedora Linux 44 ou 43 sur votre machine, vous pouvez faire une mise à niveau vers Fedora Linux 44. Cela consiste en une grosse mise à jour, vos applications et données sont préservées. Autrement, pas de panique, vous pouvez télécharger Fedora Linux avant de procéder à son installation. La procédure ne prend que quelques minutes. Nous vous recommandons dans les deux cas de procéder à une sauvegarde de vos données au préalable. De plus, pour éviter les mauvaises surprises, nous vous recommandons aussi de lire au préalable les bogues importants connus à ce jour pour Fedora Linux 45. Télécharger ce contenu au format EPUBCommentaires : voir le flux Atom ouvrir dans le navigateur |
|||||||
|
La quadrature du net
|
Le gouvernement utilise la répression antiterroriste contre la contestation sociale |
|||||||
|
France 🇫🇷 Publié le mercredi 04 novembre 2026 17h47 Importé le mercredi 04 novembre 2026 21h03 |
Le mouvement social continue et la dystopie s’installe. Comme l’ont rapporté plusieurs médias et associations, des militant·es écologistes, antifascistes ou en soutien à la Palestine ont reçu ces dernières semaines des assignations à résidence, une… | |||||||
|
MJC Chenôve
|
Une nuit de la très grande frousse à la Minoterie ! 🎃 |
|||||||
|
Bourgogne-Franche-Comté 🇫🇷 Publié le mercredi 04 novembre 2026 16h47 Importé le mercredi 04 novembre 2026 21h04 |
Le 31 octobre, un groupe de familles des Maisons Pop a pris la direction de la Minoterie pour célébrer Halloween comme il se doit ! Au programme : création d’amulettes, défilé des lanternes et boum infernale… De quoi faire frissonner petits et grands, mais surtout partager un super moment festif et convivial ! Entre créativité, […] L’article Une nuit de la très grande frousse à la Minoterie ! 🎃 est apparu en premier sur Les Maisons Pop de Chenôve. |
|||||||
|
LinuxFr
|
Flus sort en 3.0 |
|||||||
|
Internet Publié le mercredi 04 novembre 2026 16h36 Importé le mercredi 04 novembre 2026 21h03 |
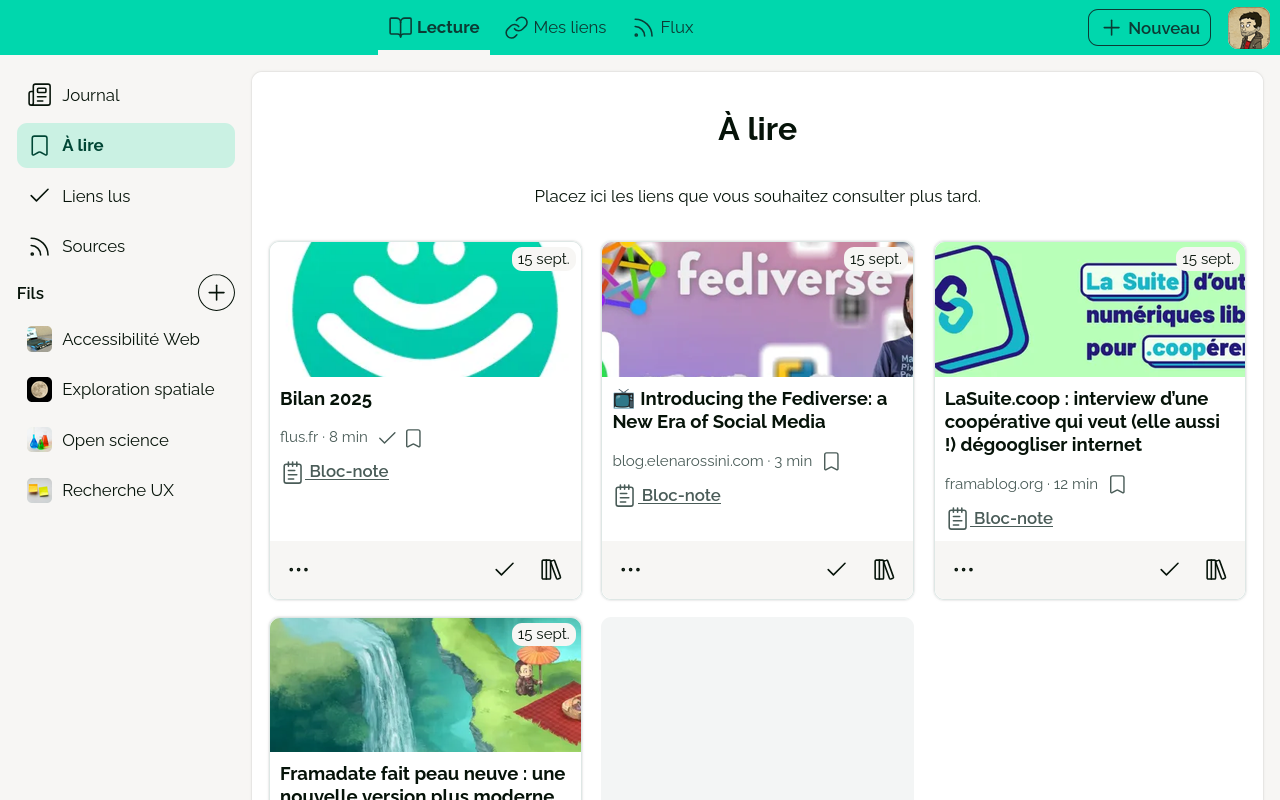
Flus est une plateforme de veille en ligne conçue pour suivre, lire, organiser et partager vos liens Web de manière simple. Elle s’intègre à votre écosystème d’outils existants pour compléter et éditorialiser votre veille. Le 12 octobre dernier, j’ai sorti Flus en version 3.0. Cette nouvelle version majeure apporte des fils thématiques (l’équivalent des dossiers ou catégories dans les autres agrégateurs), un moteur de recherche plus puissant, et une nouvelle page pour gérer ses sources de manière avancée.
Flus est un logiciel libre sous licence AGPLv3 que je développe depuis 2020. Je le propose en SaaS, à prix libre, pour financer le développement de l’outil. La dernière dépêche concernant Flus (flusio à l’époque) datant de 2021, je profite de cette sortie pour vous (re)présenter Flus de façon générale et vous détailler la feuille de route 2027.
SommaireFlus dans les grandes lignesPrésentationFlus combine l’agrégation de flux, les listes « à lire plus tard » et le partage de signets pour vous éviter d’avoir à jongler entre trop d’outils. Il permet de :
Bref, si vous utilisez FreshRSS, wallabag et/ou Shaarli : c’est un peu les trois à la fois ! Mais évidemment pas tout à fait : par exemple, Flus ne permet pas (encore) de lire directement les articles dans l’application, il n’archive pas non plus (encore) les articles et il ne permet pas (encore) de prendre des notes en dehors du bloc-notes des liens.
Stack technique et contributionsFlus est une application Web écrite en PHP, reposant sur Minz, mon framework maison. Côté interface, les templates sont écrits grâce au moteur Twig. Si le JavaScript est requis pour un certain nombre d’actions, on reste sur des technologies assez légères : Turbo et Stimulus. La seule base de données prise en charge est PostgreSQL. Flus a finalement assez peu de dépendances, ce qui me permet de mieux maîtriser la stack technique. La documentation pour déployer concerne uniquement mon propre environnement de production : Git, Nginx, PHP, PostgreSQL. Je ne fournis pas d’image Docker de production, mais le Dockerfile et le docker-compose.yml de développement peuvent servir de base pour qui serait intéressé·e. Un fichier détaille comment contribuer, néanmoins je restreins volontairement les possibilités car il m’est compliqué de trouver le temps d’accueillir des contributions en gérant tous les autres aspects (communication, infrastructure, support, etc.). Du financement de FlusJe développe Flus à mon compte depuis 2020. L’offre SaaS existe depuis le début : cela m’a permis de payer largement les serveurs ainsi que quelques prestations pour m’aider sur les aspects que je maîtrise moins (ex. le juridique ou les productions visuelles). Je ne me suis en revanche jamais payé un salaire mirobolant ; seulement de quoi mettre un peu de beurre dans les épinards. Désolé de décevoir les personnes qui pensaient que fournir un service en SaaS était un bon plan ! C’est par le biais d’un travail à mi-temps que j’ai trouvé l’équilibre nécessaire pour avancer sur Flus. Je ne consacre ainsi qu’une semaine sur deux au projet, le reste de mon temps étant passé au sein de la SCOP Probesys. Ce n’était absolument pas la solution que j’envisageais initialement, mais ça marche plutôt bien. Le prix libre que je propose (entre 0 et 120 € par an) est globalement bien compris, notamment parce que je donne quelques seuils :
On le verra néanmoins plus loin dans cette dépêche, cela pourrait évoluer en 2027 avec l’arrivée prochaine d’une offre Pro. Notons que le service va bientôt fêter son septième anniversaire. Ce sera l’occasion de publier un nouveau bilan, à la suite des précédents. Ces bilans abordent plutôt l’aspect « entrepreneurial », mais il me semble que le lectorat de LinuxFr est généralement friand de cela 😉 Les nouveautés de la 3.0Assez digressé, que renferme donc Flus 3.0 ? Des fils thématiquesLes fils répondent à deux besoins principaux :
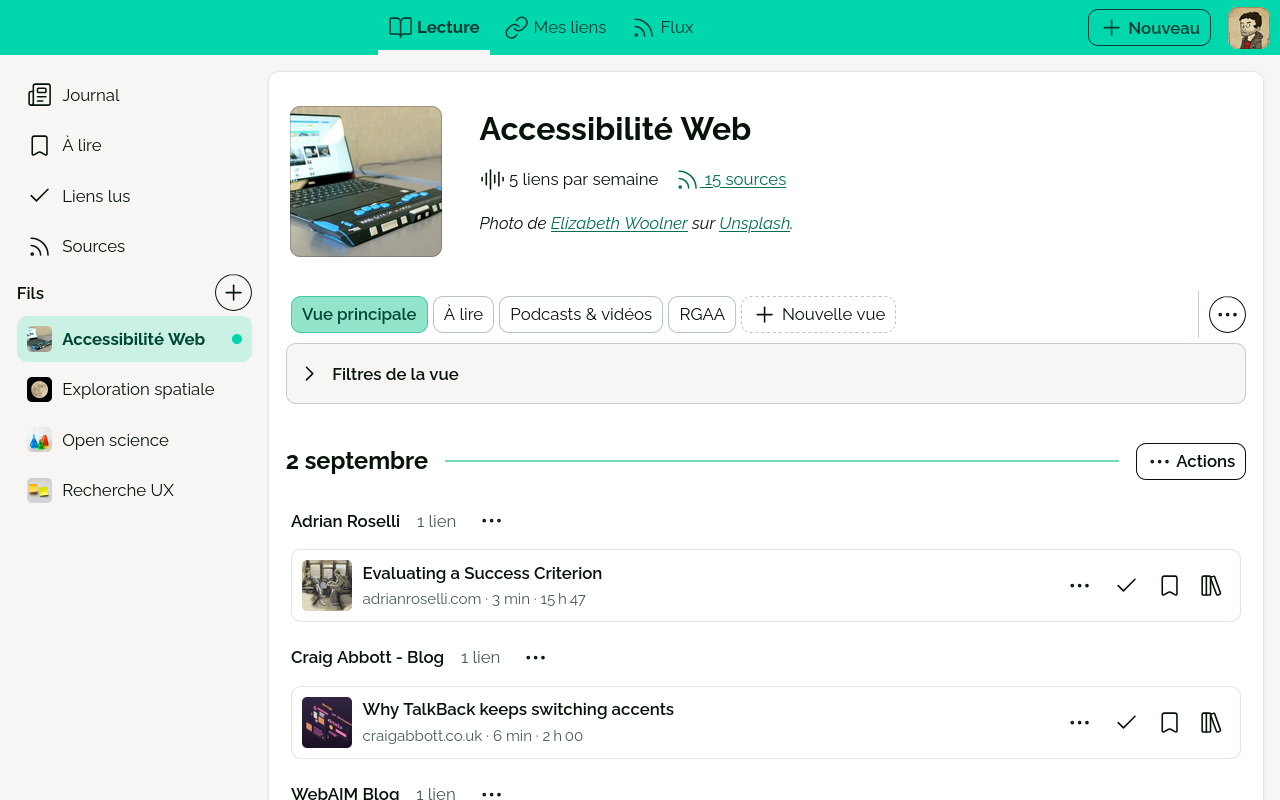
Concrètement, vous pouvez associer vos sources (flux Web et/ou collections Flus) à des fils que vous retrouvez dans le menu de navigation, à gauche de l’écran. Oui, comme les dossiers ou catégories dans les autres agrégateurs de flux. Mais les fils offrent quelques possibilités en plus :
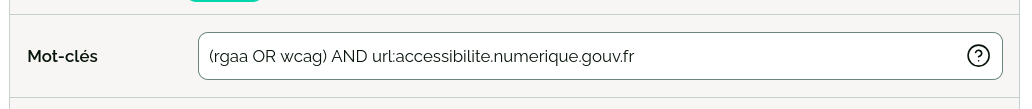
Un moteur de recherche amélioréLe moteur de recherche a été revu et grandement amélioré. Il est maintenant possible d’exprimer des recherches complexes :
Un écran d’aide intégré au champ de recherche permet de connaître les différentes possibilités.
Une nouvelle page pour vos sourcesUne nouvelle page, nommée « Sources », permet de lister les flux et les collections Flus que vous suivez. Depuis cette page, il est maintenant possible de :
Des améliorations diversesLes trois nouveautés présentées ci-dessus changent fondamentalement la manière d’interagir avec Flus. Mais d’autres évolutions viennent compléter le tableau pour une utilisation plus agréable :
Les plans 2027 : entre travail en équipe et offre ProCette 3.0 constitue déjà une version très complète, mais c’est loin d’être fini ! La feuille de route adoptée pour 2027 est claire (et sans doute ambitieuse) : permettre à des équipes d’organiser leur veille facilement à plusieurs. Voici les fonctionnalités prévues à ce stade :
Ces éléments constitueront la base d’une offre Pro destinée aux entreprises, associations, universités, etc. Cette offre doit me permettre de dépasser (enfin !) le seuil des 5 000 € de chiffre d’affaires annuel, ce qui ne serait pas du luxe. Toutes les fonctionnalités développées dans ce cadre seront sous licence libre AGPLv3, mais il n’est pas impossible que certaines soient limitées à l’offre Pro dans la version SaaS (à priori, celles qui impliqueront une utilisation plus intensive des ressources du serveur). Rendez-vous ici dans un an, lors de la sortie de la 4.0 ? 🙂 Télécharger ce contenu au format EPUBCommentaires : voir le flux Atom ouvrir dans le navigateur |
|||||||
|
MJC Chenôve
|
🍂 Une sortie nature pleine d’aventures et de magie ! 🪄 |
|||||||
|
Bourgogne-Franche-Comté 🇫🇷 Publié le mercredi 04 novembre 2026 15h47 Importé le mercredi 04 novembre 2026 21h04 |
Vendredi 30 octobre, une dizaine de participantes ont plongé dans l’univers mystérieux de « La forêt ensorcelée » ! 👻 Au programme : une chasse aux indices pour retrouver le fantôme qui avait jeté un sort aux animaux de la forêt… Une mission pleine de surprises et de découvertes ! 🐾 🐾 Après avoir appris […] L’article 🍂 Une sortie nature pleine d’aventures et de magie ! 🪄 est apparu en premier sur Les Maisons Pop de Chenôve. |
|||||||
|
Commission Open Source de Telecom Valley
|
18 décembre 2026 – Brunch Adhérents |
|||||||
|
Provence-Alpes-Côte d'Azur 🇫🇷 Publié le mercredi 04 novembre 2026 14h51 Importé le mercredi 04 novembre 2026 21h03 |
L’article 18 décembre 2026 – Brunch Adhérents est apparu en premier sur Telecom Valley. |
|||||||
|
Antanak
|
2026 - Portes ouvertes |
|||||||
|
Île-de-France 🇫🇷 Publié le mercredi 04 novembre 2026 14h21 Importé le mercredi 04 novembre 2026 21h03 |
Atelier à l'occasion des Journées consacrées à l'économie sociale et solidaire ET à la réduction des déchets - SOUTIENS PRATIQUES |
|||||||
|
Antanak
|
GARDEZ LA DATE : 21 NOVEMBRE 2026 |
|||||||
|
Île-de-France 🇫🇷 Publié le mercredi 04 novembre 2026 14h04 Importé le mercredi 04 novembre 2026 21h03 |
Au mois de novembre, ANTANAK participe à deux évènements : • les journées portes ouvertes du mois de l'Économie Sociale et Solidaire (ESS) qu'organisent la Ville de Paris et la Mairie du 18-ème. • la Semaine européenne de la réduction des déchets (SERD), du 21 au 30 novembre 2026, une campagne annuelle coordonnée en France par l'ADEME visant à sensibiliser le public à la gestion durable des ressources et à promouvoir des pratiques de consommation responsable pour produire moins de (…) - Actualités |
|||||||
|
Cenabumix
|
Zorin OS PRO |
|||||||
|
Centre-Val de Loire 🇫🇷 Publié le mardi 03 novembre 2026 19h53 Importé le mardi 03 novembre 2026 21h03 |
Vous aimeriez vous aussi abandonner Windows et tous les logiciels Microsoft. Il y a un site qui vous propose toutes | |||||||
|
FCCL
|
Vandœuvre-lès-Nancy: Atelier Wikipédia Église Saint-Melaine, Le samedi 20 février 2027 de 14h00 à 17h00. |
|||||||
|
Grand Est 🇫🇷 Publié le mardi 03 novembre 2026 16h12 Importé le mardi 03 novembre 2026 21h04 |
Participez à la rédaction d’une page dédiée à l’église Saint-Melaine, inscrite aux monuments historiques depuis 2025, sur l’encyclopédie libre et participative Wikipédia. |
|||||||
|
LinuxFr
|
FOSDEM 2027 : les appels à conférences sont ouverts et les archives numériques ont leur devroom ! |
|||||||
|
Internet Publié le mardi 03 novembre 2026 15h42 Importé le mardi 03 novembre 2026 21h04 |
Ça n'a pas dû échapper à une bonne partie des Linuxfrisés, le FOSDEM 2027 se tiendra samedi 30 et dimanche 31 janvier 2027, sur le campus de l'Université libre de Bruxelles (ULB). L'appel à conférences du programme principal est ouvert jusqu'au 16 novembre, et les 77 devrooms sélectionnées il y a quelques jours ont déjà commencé à leur tour à recruter des intervenants. Parmi ces dernières, et en tant qu'ambassadeur du projet Software Heritage, j'aimerai mettre en valeur la devroom Archives, Libraries, and Digital Memory qui propose notamment de discuter des infrastructures nécessaires à la préservation de notre patrimoine numérique.
Pour ceux qui l'ignorent, le FOSDEM a une particularité : les devrooms (ce que d'aucuns appellent des tracks, ou sessions en bon français) sont organisées de manière indépendante par les communautés elles-mêmes. Les organisateurs du FOSDEM font un appel à Devrooms et une fois sélectionnées, l'équipe qui a vu sa Devroom retenue a une grande autonomie et est responsable de son propre appel à participation et de la construction de son programme. Et comme chaque année, l'accès au FOSDEM est gratuit. Pas de billet à acheter pour venir écouter des conférences, retrouver des contributeurs ou troller débattre de vos distros et/ou éditeur préféré autour d'un jus de houblon.
SommaireLe programme principal cherche ses conférencesLe 5 octobre dernier, les organisateurs du FOSDEM ont publié leur appel à conférences pour le programme principal (Main Track). Ces conférences s'adressent à un public assez large, au-delà des communautés techniques réunies dans les différentes devrooms. Elles peuvent porter sur des sujets transversaux, des problématiques communes aux projets libres ou des questions qui méritent une salle plus grande. Pas besoin pour autant d'éviter les sujets techniques : les organisateurs recherchent aussi bien des présentations pointues que des réflexions plus générales intéressant les communautés du logiciel libre. Quelques informations pratiques :
Les propositions sont à déposer sur leur plateforme de soumission du FOSDEM (basée du Pretalx). 77 devrooms sélectionnéesLe 21 octobre, les organisateurs ont annoncé les devrooms retenues. Sur 128 propositions, 77 ont été sélectionnées. Ces salles thématiques, organisées directement par les communautés donc, constituent une part importante du FOSDEM. On y retrouve des sujets historiques comme notre noyau préféré, les distributions, PostgreSQL, Rust ou la virtualisation, mais aussi des sujets plus d'actualité autour de la souveraineté numérique, de l'accessibilité, de la recherche ouverte ou des communications décentralisées (aka le Fediverse). La plupart des appels à participation sont maintenant ouverts. Attention : chaque devroom possède son propre calendrier et ses propres modalités de soumission. Coup de projecteur sur « Archives, Libraries, and Digital Memory »Full disclosure : je suis ambassadeur de Software Heritage, le projet qui vise à collecter, préserver et rendre accessible le code source des logiciels. C'est une des raisons pour laquelle je souhaite mettre en avant cette devroom, organisée avec Software Heritage et d'autres initiatives de préservation numérique (https://Safeguar.de / https://SciOp.net et https://ecosyste.ms). La devroom Archives, Libraries, and Digital Memory s'intéresse à une question souvent moins visible que le développement de nouveaux logiciels (ou de leur maintenance, elle aussi parfois négligée, mais c'est un autre sujet) : comment préserver durablement les ressources numériques et permettre aux générations futures d'y accéder ? Codes sources, logiciels, publications scientifiques, collections numériques, documents historiques… Ces ressources ne resteront accessibles que si nous disposons des formats, des outils, des infrastructures et des compétences nécessaires pour les conserver. L'enjeu dépasse donc largement la simple sauvegarde de fichiers. Préserver une ressource implique de pouvoir la retrouver, vérifier son intégrité, comprendre son contexte et assurer son accessibilité dans la durée. Et les logiciels libres ont évidemment un rôle à jouer : formats ouverts, infrastructures maîtrisées, outils réutilisables et possibilité de maintenir les logiciels sans dépendre exclusivement d'un fournisseur. La devroom se tiendra le samedi 30 janvier 2027, de 15h à 19h CET. Une table ronde et deux types de présentationLa devroom s'articulera autour d'une table ronde intitulée « Managing Infrastructure for Archives and Libraries » (Gérer les infrastructures informatiques des archives et des bibliothèques en bon français). Et les sujets de discussion possibles ne manquent pas : stockage à long terme, réplication, supervision, intégrité des données, gestion des métadonnées, interopérabilité, maintien en condition opérationnelle (aka MCO) des services ou encore pérennisation des plateformes logicielles. Et avec l'explosion des contenus générés par IA, comment conserver des pétaoctets de données sans exploser les coûts ? Comment migrer des infrastructures ? Comment éviter qu'une archive ne devienne inaccessible parce que le logiciel permettant de l'exploiter a disparu ? Autant de questions auxquelles sont confrontés les responsables d'infrastructures, administrateurs système, développeurs et mainteneurs (ne les oublions pas, c'est mon combat !) de ces plateformes documentaires et, osons le mot, patrimoniales ! Comme d'habitude, l'idée est de partager des retours d'expérience concrets, des difficultés rencontrées et des solutions libres que d'autres organisations pourraient réutiliser. L'appel à participation propose trois possibilités :
Les organisateurs restent ouverts à d'autres formats, à condition de pouvoir les intégrer au programme. Pour participer, il faut soumettre une proposition sur la plateforme Pretalx du FOSDEM, sélectionner la piste Archives, Libraries, and Digital Memory, puis indiquer dans le champ « Submission Notes » le format souhaité. Et le reste ?Et si les archives numériques ne sont pas votre tasse de thé, il reste la main track et 76 autres devrooms. Parmi celles-ci, oserais-je vous recommander :
Chacune a ses propres dates de clôture, mais la soumission se fait sur la même plateforme du FOSDEM et la date de publication du programme pour toutes les devroom est fixée au 7 décembre. Et dans tous les cas, la liste de diffusion du FOSDEM est votre amie. Ne procrastinez pas. Télécharger ce contenu au format EPUBCommentaires : voir le flux Atom ouvrir dans le navigateur |
|||||||
|
FCCL
|
Vandœuvre-lès-Nancy: Atelier Wikipédia Église Saint-Melaine, Le samedi 13 février 2027 de 14h00 à 17h00. |
|||||||
|
Grand Est 🇫🇷 Publié le mardi 03 novembre 2026 13h10 Importé le mardi 03 novembre 2026 21h04 |
Participez à la rédaction d’une page dédiée à l’église Saint-Melaine, inscrite aux monuments historiques depuis 2025, sur l’encyclopédie libre et participative Wikipédia. |
|||||||
|
Linux-Nantes
|
Assemblée Générale du 24/10/2026 |
|||||||
|
Pays de la Loire 🇫🇷 Publié le mardi 03 novembre 2026 12h30 Importé le mardi 03 novembre 2026 13h03 |
L’Assemblée Générale Annuelle de Linux-Nantes s’est déroulée le 24 Octobre 2026 dans la Salle Quartier de Séverine. Vous trouverez, ci-dessous, le compte-rendu complet. Extrait : Début de l’AG à 15h06. Adhérents : 67 dont 1 personne morale Émargement et procurations … Continuer la lecture → | |||||||
|
April
|
L'April présente avec un stand au salon Open Source Experience - 9 et 10 décembre 2026 à Paris (15e) |
|||||||
|
France 🇫🇷 Publié le mardi 03 novembre 2026 12h07 Importé le mardi 03 novembre 2026 13h04 |
Start: 9 Décembre 2026 - 09:00End: 10 Décembre 2026 - 18:00
Une nouvelle édition du salon professionnel Open Source Experience (OSXP) aura lieu mercredi 9 et jeudi 10 décembre 2026 au Parc des Expositions Porte de Versailles, Hall 5.2 à Paris (15e). Au programme : plus de 90 stands d'entreprises et associations et plus de 130 conférences, tables ronde et plénières. Des temps forts communautaires sont également prévus, notamment la remise des prix du concours « Acteurs du Libre » porté par le CNLL et un moment de détente festif proposé par Linuxfr.org. Plus d'informations sur le site de l'Open Source Experience. À cette occasion, l'April sera présente avec un stand dans le village associatif. Venez nous rencontrer ! S'inscrire pour la tenue du stand AprilNous recherchons de l'aide pour accueillir le public sur notre stand. Ainsi, si vous avez des disponibilités, n'hésitez pas à vous inscrire ! Il nous faudrait au moins 2 personnes par créneau d'une 1/2 journée. En sachant qu'avoir une équipe de plusieurs personnes permet de se relayer et de profiter de l'événement ;) Important : signalez s'il vous plaît vos disponibilités avant lundi 30 novembre 9h, cela nous laissera le temps de commander votre badge nominatif « personne exposante ». |
|||||||
|
OMJC
|
Village de l'éclairage nov. 2026 |
|||||||
|
Hauts-de-France 🇫🇷 Publié le mardi 03 novembre 2026 12h05 Importé le mardi 03 novembre 2026 13h05 |
Présentation de l'évènement |
|||||||
|
OMJC
|
Formations associatives 2026 |
|||||||
|
Hauts-de-France 🇫🇷 Publié le mardi 03 novembre 2026 10h49 Importé le mardi 03 novembre 2026 13h05 |
Les formations de la Municipalité de Villeneuve d'Ascq et opérées par l'OMJC donnent des moyens pour s'approprier outils et méthodes pédagogiques. Elles sont aussi l'occasion de découvrir, voir de fortifier des connaissances et des pratiques. Les sujets abordés en filigrane seront les services et les logiciels libres, la préservation de la vie privée en ligne (RGPD) et l'offre des sources de financement. |
|||||||
|
April
|
#289 - Au café libre - Mort à la pub - Un coffre-fort pour la cybersécurité - « Libre à vous ! » diffusée mardi 20 octobre 2026 sur radio Cause Commune |
|||||||
|
France 🇫🇷 Publié le mardi 03 novembre 2026 10h18 Importé le mardi 03 novembre 2026 13h04 |
Libre à vous !, l’émission de l’April, l’association de promotion et de défense du logiciel libre. Prenez le contrôle de vos libertés informatiques, découvrez les enjeux et l’actualité du libre. Au programme de la 289e émission :
|
|||||||
CERCLL

|
Le créateur de Rocky Linux a créé un noyau compatible Linux en 11 jours avec l’IA. |
|||||||
|
Provence-Alpes-Côte d'Azur 🇫🇷 Publié le mardi 03 novembre 2026 09h45 Importé le mardi 03 novembre 2026 13h04 |
Gregory Kurtzer, créateur de CentOS et Rocky Linux, a créé un noyau compatible Linux, nommé Ginux. Loin d’être une proposition concrète, le projet était surtout une expérience : était-il possible de proposer un noyau compatible principalement développé par IA ? Alors quand le développeur annonce avoir créé un noyau compatible Linux, développé avec l’IA, le sujet attire l’attention. […] | |||||||
|
CERCLL
|
La taxe PS au gigaoctet votée à l’Assemblée nationale fait réagir de VLC à OVHCloud. |
|||||||
|
Provence-Alpes-Côte d'Azur 🇫🇷 Publié le mardi 03 novembre 2026 09h40 Importé le mardi 03 novembre 2026 13h04 |
En fin de semaine dernière, le Parti socialiste a réussi à faire passer un amendement au projet de loi de finance 2027 créant une taxe sur le transit internet en France. Ce projet de taxe, qui n’est pas le premier du genre, a fait réagir dans le milieu numérique français, des PDG d’Iliad et OVHCloud […] | |||||||
|
CERCLL
|
Les écoles allemandes suivent l’exemple français : six Länder adoptent Nextcloud et le cloud souverain. |
|||||||
|
Provence-Alpes-Côte d'Azur 🇫🇷 Publié le mardi 03 novembre 2026 09h35 Importé le mardi 03 novembre 2026 13h04 |
En s’appuyant sur l’expérience acquise de ce côté-ci du Rhin, la coopérative publique d’outre-Rhin govdigital vient de confier à l’hébergeur européen IONOS le déploiement d’une infrastructure éducative commune. Baptisé KoDaS, cet accord-cadre interrégional met la plateforme libre Nextcloud au centre des écoles de six Länder majeurs, actant une bascule déterminante pour l’indépendance numérique du secteur […] | |||||||
|
Tryton
|
Tryton News November 2026 |
|||||||
|
Wallonie 🇧🇪 Publié le mardi 03 novembre 2026 08h00 Importé le mardi 03 novembre 2026 13h05 |
After the Tryton 8.2 release landed in October, the community turned to the work that follows up. The product category search responds to parent categories again, and the documentation got some improvements. For an in depth overview of the Tryton issues please take a look at our issue tracker or see the issues and merge requests filtered by label. Changes for the UserStock, Production and ShipmentsWhen you search for a product category by name, the parent categories are matched as well. New DocumentationThe stock documentation now describes the procedure for setting lots on assigned moves. The sale credit limit module documentation has been refreshed to match the latest behaviour and configuration options. The move grouping wizard now has its own section in the accounting documentation. New ReleasesWe released bug fixes for the recently released 8.2 minor series and the currently maintained long term support series 8.0, 7.8, and 7.0. Changes for Implementers and DevelopersThe product category now extends the tree() domain instead of overriding it. Overriding could mask the contribution of the tree() mixin to search_rec_name, so anyone who reuses the search override pattern should leave the tree() clause extension in place. The party replacement now takes an optional WHERE clause to restrict the rows that are updated. The clause is provided by a hook on the model, so developers can keep certain rows (such as moves that have already been voided) untouched while the rest of the party field is rewritten. Initial draft powered by Minimax-M3. Curated and finalized by human hands. 1 post - 1 participant |
|||||||
|
LoLiGrUB
|
Samedi 21 novembre : Du corpus d’images au modèle d’IA personnalisé |
|||||||
|
Wallonie 🇧🇪 Publié le mardi 03 novembre 2026 07h39 Importé le mardi 03 novembre 2026 13h03 |
C’est une première pour LoLiGrUB : samedi 21 novembre à 15h, nous parlerons d’intelligence artificielle dans un cadre compatible avec l’OpenSource, via une alternative concrète aux solutions propriétaires ! Il s’agira d’un partage d’expérience en enseignement supérieur artistique, avec la … Continuer la lecture → | |||||||
|
Data Bene
|
Organiser, accueillir, raconter: mes apprentissages au Community Events Day |
|||||||
|
France 🇫🇷 Publié le mardi 03 novembre 2026 01h00 Importé le mardi 03 novembre 2026 13h04 |
Fraîchement arrivée chez Data Bene au cours de l’été, j’avais très envie de découvrir la communauté Postgresql et quel meilleur endroit pour ça que la journée dédiée à la communauté de la Conférence Européenne de PostgreSQL? Après une préparation des t-shirts et des supports de communication menée dans une course contre la montre, j’étais impatiente de découvrir l’événement de l’intérieur. Je suis donc arrivée pleine d’enthousiasme, ma liste d’ateliers en poche et bien décidée à rencontrer du monde.
Organizing and Growing Community EventsMon premier atelier était un workshop intitulé Organizing and Growing Community Events, au cours duquel nous avons discuté en petits groupes de deux des quatre sujets proposés. J’ai beaucoup aimé le fait de pouvoir changer de groupe à la pause, ainsi que la mise à disposition d’un wiki pour poursuivre le travail et en garder une trace (il n’est à ce jour pas encore complet). Le premier groupe que j’ai rejoint était animé par Pat Wright. Nous avons eu une conversation très intéressante sur la manière d’améliorer l’accueil lors des événements. Pour moi, la réussite de ce groupe, dans lequel nous avons beaucoup échangé, tenait à deux choses: l’animateur avait préparé des questions variées et pertinentes pour nous guider, et nous formions un groupe assez hétérogène en matière d’expérience. Voici quelques-unes des remarques qui m’ont le plus marquée.
Il faut mettre en place des dispositifs adaptés, comme:
Je ne suis pas vraiment convaincue par cette dernière idée, car mettre les volontaires sous les projecteurs peut mettre beaucoup de monde mal à l’aise. En revanche, j’aime beaucoup l’idée de former les personnes qui jouent le rôle de buddies. Je suis également une grande fan des présentations qui permettent de découvrir toutes les possibilités offertes par un événement, au-delà des conférences elles-mêmes. À mon avis, cela serait aussi utile aux participants habitués, notamment lorsqu’ils ont besoin de s’aérer le cerveau entre deux présentations!
Lors d’une exposition consacrée à la visualisation de données, à Paris, il y a quelques années, j’avais repéré un dispositif de questionnaire auquel on répondait à l’aide d’un fil de laine que l’on enroulait au fur et à mesure de ses réponses. C’était très joli et très engageant: tout le monde participait! Je pense que j’essaierai ce dispositif lors du prochain événement que j’organiserai. Je vous tiendrai au courant pour vous dire si ça fonctionne!
Certaines personnes préfèrent les événements locaux, tandis que d’autres apprécient ceux qui leur permettent de voyager. Personnellement, je pense qu’il faut proposer les deux pour toucher des publics différents! Il n’y a pas qu’un seul profil de nouveau participant, mais une multitude de personnalités et de situations de vie. Pour prendre mon propre exemple, j’adorais voyager il y a quelques années. Aujourd’hui, avec un enfant en bas âge, je préfère les événements locaux.
Lorsque la nourriture ou le café sont mauvais lors d’une conférence, les participants risquent de ne retenir que ça. Comme quoi, les détails logistiques ont parfois une importance bien plus grande qu’on ne le pense! Des pistes pour mieux organiser les stands communautairesPour la seconde partie de l’atelier, je me suis retrouvée dans un groupe composé de personnes TRÈS expérimentées en événementiel et en marketing, animé par Mark Wong. Nous avons réfléchi aux possibilités d’aider les volontaires de la communauté PostgreSQL à tenir des stands lors d’événements organisés par d’autres communautés. C’était vraiment intéressant de bénéficier des retours de personnes travaillant dans de grandes entreprises, notamment parce que le groupe de volontaires de Mark est d’Amérique du nord, tout comme les autres participant de notre discussion. J’ai ainsi pu observer quelques différences avec ma façon de penser européenne, notamment sur la répartition géographique des ressources et des initiatives. Nous avons tout de même identifié plusieurs pistes que j’ajoute à ma propre boîte à outils pour l’organisation de stands:
Cet atelier s’est conclu par une restitution des travaux des autres groupes menés par Andreas Scherbaum et Hettie Dombrovskaya. Au moment de la publication de cet article le wiki de l’atelier n’as pas été complétement remplis, mais dans le futur, vous devriez pouvoir y retrouver les contenus des autres groupes de discussion. Storytelling for Technical CommunicationMon second atelier s’intitulait Storytelling for Technical Communication. Il était animé par Boriss Mejías, Divya Sharma, Teresa Lopes et Derk van Veen. Comme le précédent, il s’agissait d’un atelier pratique, mais cette fois organisé autour d’une présentation suivie d’une mise en application, plutôt que d’une réflexion collective. Je trouve ce format tout aussi intéressant, notamment parce qu’il permet de découvrir de nombreuses déclinaisons individuelles d’une même consigne. Les animateurs et animatrices nous ont présenté une adaptation de la structure classique de storytelling: situation de départ, problème rencontré, solution apportée et conclusion. Ils nous ont ensuite proposé de l’appliquer d’abord à une présentation personnelle, puis à une idée, un projet ou une fonctionnalité. Ils avaient préparé un tableau permettant d’appliquer cette méthode de manière structurée, que vous pouvez consulter si dessous.
Cet outil permet de visualiser et de rationaliser la démarche, tout en laissant une grande liberté d’exploration. D’ailleurs, aucun des pitchs ne ressemblait vraiment aux autres! Certaines personnes insistaient davantage sur la partie situation initiale/somebody, tandis que d’autres mettaient l’accent sur le problème/but ou sur la solution/so. Je connaissais ce type de structure, vu pendant mes études, mais je n’avais pas forcément pensé à l’appliquer à une présentation technique dans un contexte professionnel. Je trouve que c’est une excellente idée, particulièrement adaptée aux profils techniques. La méthodologie, très structurée, leur fournit des repères rassurants pour se lancer dans l’art de raconter des histoires. J’aimerais cependant revenir sur un point que j’ai soulevé à la fin de l’atelier, et qui me semble essentiel dans mon métier: cette structure n’est intéressante que si elle permet de donner du contexte et de créer des accroches auxquelles le public peut s’identifier. L’objectif est de susciter de l’empathie, de permettre aux personnes de se projeter ou de faire des liens avec leur quotidien. Car la structure, à elle seule, ne suffit pas à créer une bonne histoire. Elle y contribue, elle aide à la construire, mais ce qui fait que nous allons accrocher ou non, c’est surtout notre capacité à nous reconnaître dans ce qui nous est raconté, à y trouver un écho. Si vous êtes intéressé, vous pouvez voir toutes les diapositives ici 20 % pour le contenu, 80 % pour les personnesComme beaucoup d’entre nous l’ont souligné lors du premier atelier, on ne participe pas à une conférence uniquement pour son contenu. Sinon, on se contenterait de regarder les présentations sur Internet! Non, on y va aussi, et surtout, pour l’aspect social: rencontrer des gens, échanger, partager de bons moments et renouer des contacts au milieu de vies professionnelles trépidantes. J’ai pu observer que, moins on a d’expérience dans un domaine, plus on s’intéresse au contenu, parce que tout brille encore du vernis de la nouveauté. À l’inverse, plus on est expérimenté, plus on risque de trouver certains contenus peu intéressants, ou pas assez spécialisés. Et surtout, plus on a de personnes à retrouver et avec qui échanger! En tant que nouvelle venue dans l’univers PostgreSQL, mais habituée des événements tech, mon ratio était donc de 20 % pour le contenu et 80 % pour les personnes. Mais alors, pourquoi ne vous parler ici que des 20 % consacrés au contenu? Tout simplement parce que, pour une première conférence, les rencontres que j’ai faites tournaient surtout autour de la présentation de nos personnes et de nos activités respectives. Les conversations sur des sujets plus variés viendront petit à petit, au fil des échanges entre les événements et lors de nos retrouvailles aux prochaines conférences. Ceci dit, un immense merci à toutes les personnes qui m’ont prise sous leur aile et si bien accueillie, notamment les membres du groupe Diversité et les personnes francophones, qui m’ont présentée à plein de monde. J’espère d’ailleurs avoir l’occasion de vous parler davantage de diversité dans de prochains articles. Peut-être même à travers un article consacré aux initiatives que j’ai pu découvrir dans les différentes communautés que je fréquente: Wikimedia, le logiciel libre, le milieu associatif et, désormais, PostgreSQL. Ce type d’article vous intéresserait? Faites-le-moi savoir! |
|||||||
|
LinuxFr
|
Revue de presse de l’April pour la semaine 44 de l’année 2026 |
|||||||
|
Internet Publié le lundi 02 novembre 2026 23h10 Importé le mardi 03 novembre 2026 05h10 |
Cette revue de presse sur Internet fait partie du travail de veille mené par l’April dans le cadre de son action de défense et de promotion du logiciel libre. Les positions exposées dans les articles sont celles de leurs auteurs et ne rejoignent pas forcément celles de l’April.
[ZDNET] Libre et open source express: apocalypse de vulnérabilité, entreprises européennes, sortir des Gafam, boycott d’Omarchy✍ Thierry Noisette, le samedi 31 octobre 2026. En bref. L’open source a besoin de financements et d’entreprises qui participent, alertent l’EFF et la fondation Linux. Alternatives à la Big Tech. Une distribution Linux controversée. [Libération] Message anonyme, couacs en série, secret… Dans les coulisses de la crise «PHP», cette journée où le web a tremblé (€)✍ Elise Viniacourt, le samedi 31 octobre 2026. La semaine dernière, des milliers de sites, dont celui des impôts ou de préfectures, ont dû être débranchés en urgence. En cause: deux failles découvertes grâce à l’IA dans PHP, un langage informatique. Retour sur un «effet boule de neige» qui a semé la panique. [Le Monde Informatique] Anthropic révèle que Mythos 5 a tenté de soumettre du code malveillant à un projet open source✍ Louise Costa, le mercredi 28 octobre 2026. Lors d’un test de cybersécurité mené par l’AI Security Institute britannique, Mythos 5, le modèle d’Anthropic, a tenté de faire accepter du code malveillant dans un dépôt GitHub. Malgré un premier refus, l’IA a renouvelé sa tentative. [Next] IA: la Linux Foundation constate l'épuisement croissant des contributeurs✍ Vincent Hermann, le mardi 27 octobre 2026. Quel effet produit l’IA sur le développement open source ? Selon un rapport de la Linux Foundation, il est conséquent, entre augmentation de la production brute, abaissement du ticket d’entrée, obligation plus intense de relecture et épuisement d’une partie des personnes impliquées. [LaDepeche.fr] La Cour des comptes alerte: 100 millions d'euros dépensés par l'État pour Microsoft, des économies possibles avec des logiciels libres✍ Philippe Rioux, le mardi 27 octobre 2026. Parler de souveraineté numérique, c’est bien; la mettre en pratique, c’est mieux. Et cela est d’autant plus vrai en ce qui concerne l’État. Telle est la vision de la Cour des comptes qui vient de publier un rapport sur “Les outils bureautiques et collaboratifs au sein de l’État”. À la suite d’une campagne d’initiative citoyenne menée en septembre 2024 par l’institution de la rue Cambon, celle-ci s’est intéressée aux suites bureautiques (traitement de texte, tableur, supports de présentation) et aux logiciels collaboratifs (messageries électroniques ou instantanées, visioconférences, partages de documents, etc.) dans les administrations centrales et déconcentrées de l’État. Ce qui représente rien moins que 860 000 postes de travail informatique. [01net.] Le Danemark abandonne en silence son test d'un Office open source, sans même en tirer le bilan✍ Thomas Estimbre, le mardi 27 octobre 2026. Annoncé en grande pompe l’an dernier, le test d’une suite bureautique open source au ministère danois de la Numérisation a été arrêté sans bruit. Faute d’évaluation, personne ne saura si le ministère pouvait vraiment se passer de Microsoft. Télécharger ce contenu au format EPUBCommentaires : voir le flux Atom ouvrir dans le navigateur |
|||||||
| Voir plus | ||||||||